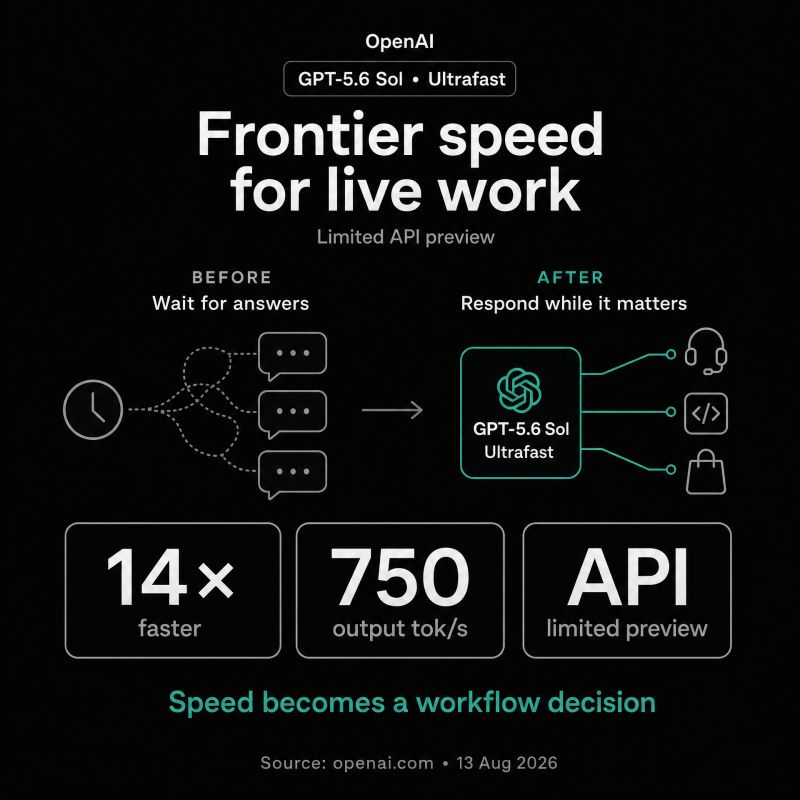
OpenAI właśnie zapowiedziało sposób, by uczynić opóźnienie modelu frontier kwestią decyzji produktowej — a nie degradacją modelu. Do 14× szybciej. 🧵
W trakcie żywej rozmowy z obsługą klienta czy incydentu produkcyjnego, odpowiedź, która dociera po tym, jak moment minął, ma ograniczoną wartość operacyjną.
Zespoły zwykle obcinały opóźnienia, przełączając się na mniejszy lub bardziej wyspecjalizowany model. Tworzy to niezręczny kompromis: inteligencja albo responsywność.
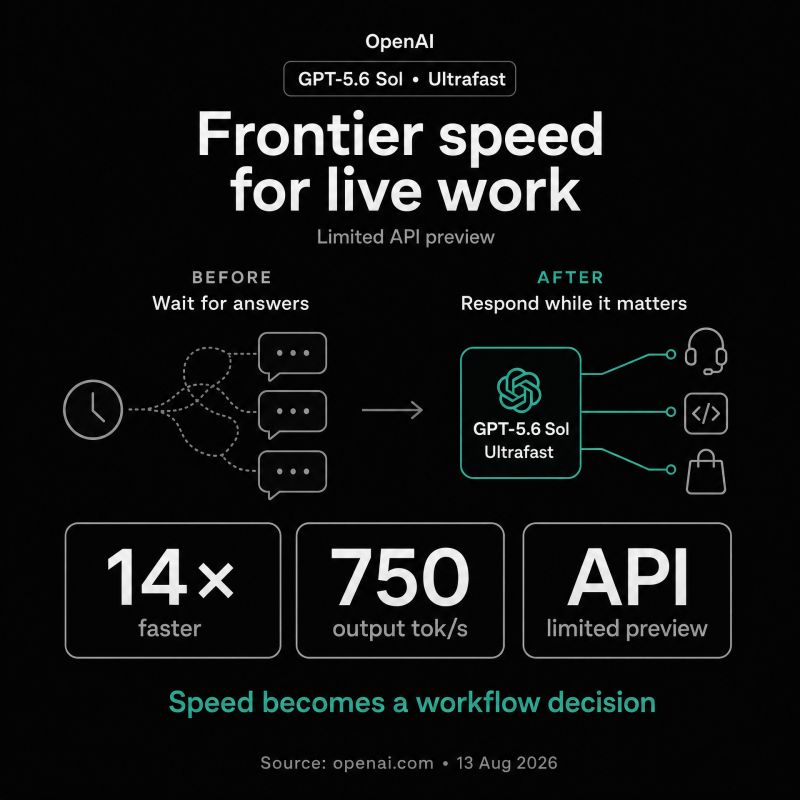
Nowa ultraszybka warstwa API od OpenAI uruchamia GPT-5.6 Sol z prędkością do 14× większą niż przetwarzanie Standard, według OpenAI. Zasilana przez Cerebras, została zaprojektowana do generowania do 750 tokenów wyjściowych na sekundę.
- Do 14× szybciej niż przetwarzanie Standard
- Do 750 tokenów wyjściowych na sekundę
- Zbudowana pod workflow wrażliwe na czas
- Najpierw dostępna w API OpenAI
Najciekawsza część to nie „szybszy czat”. To ciaśniejsze pętle człowiek-w-pętli (human-in-the-loop): przeczytaj logi, przetestuj hipotezę, zadaj kolejne pytanie — zanim system się jeszcze zmieni.
Moja szczera opinia: to ograniczony podgląd, a nie szeroka dostępność, a przepustowość z nagłówka to nie to samo, co end-to-end opóźnienie produktu. Ale jeśli frontierowe wnioskowanie potrafi niezawodnie zmieścić się w budżecie odpowiedzi żywego workflow, niektóre założenia UX agentów będą musiały ulec zmianie.
📚 Źródło: https://lnkd.in/duJGnbnJ
P.S. Gdzie opóźnienie modelu psuje Twój workflow dzisiaj? 👇